Kubernetes vs Shepherd: мінімальний оркестратор
Written by:
Igor Gorovyy
DevOps Engineer Lead & Senior Solutions Architect
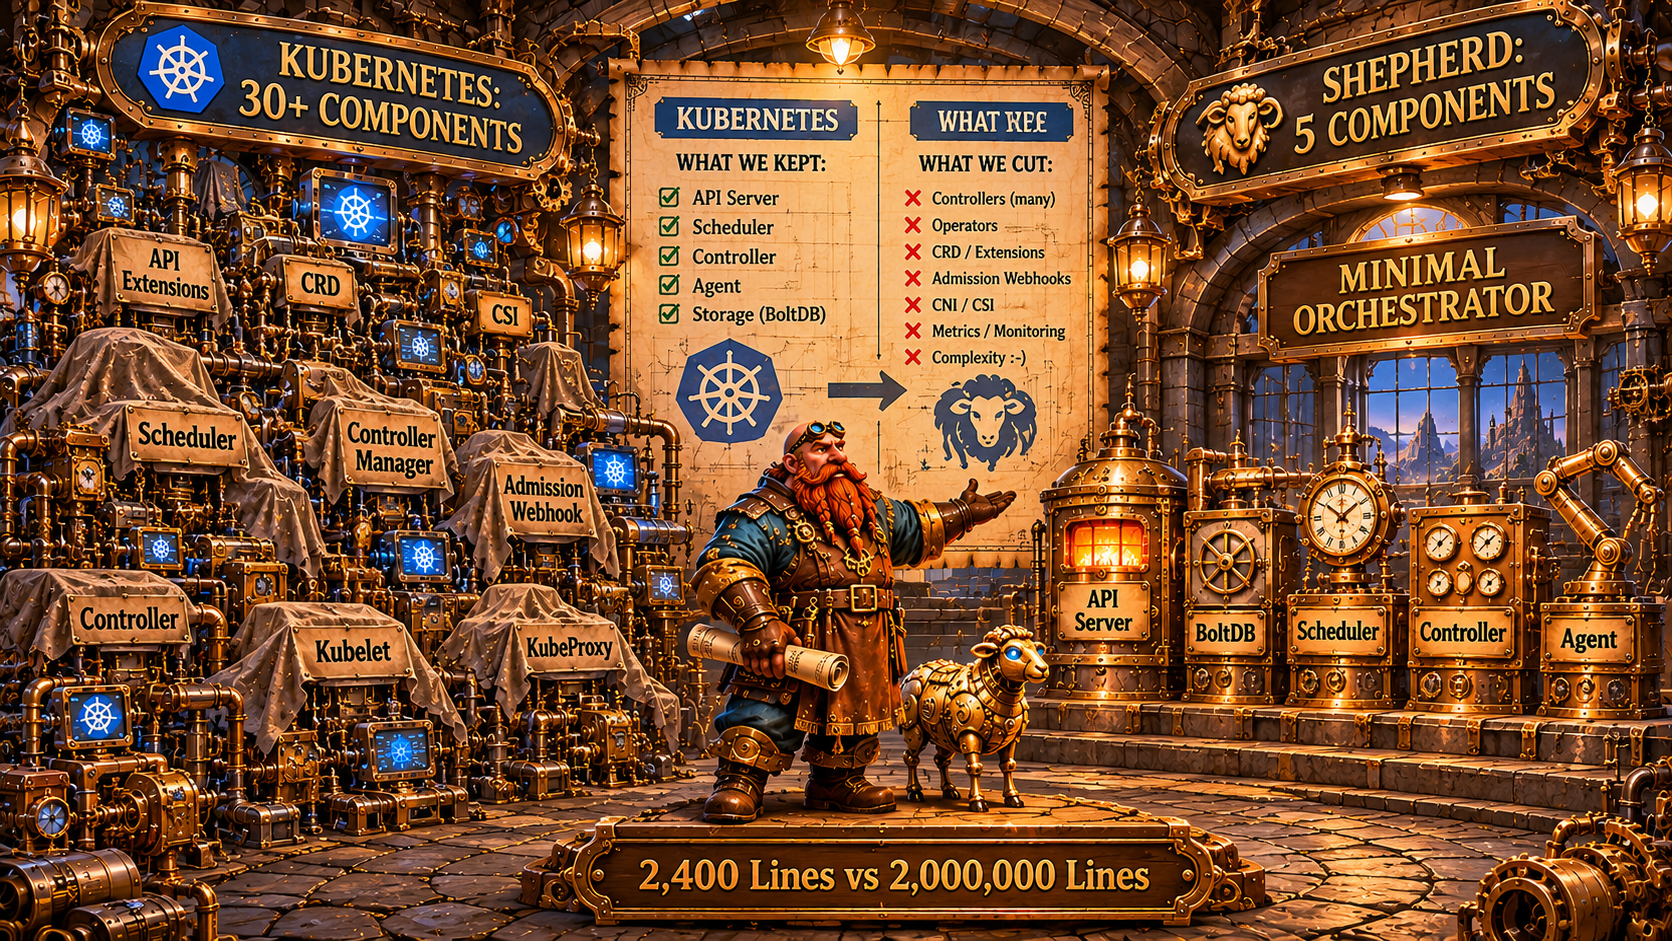
Kubernetes складається з десятків компонентів. Shepherd реалізує п'ять. Ось що виявилось необхідним мінімумом для працюючої оркестрації, і що ми свідомо вирізали.
Що залишилось
graph TB
    subgraph "Є в обох"
        API["API Server<br/>K8s: kube-apiserver<br/>Shepherd: net/http REST"]
        STORE["State Store<br/>K8s: etcd cluster<br/>Shepherd: BoltDB file"]
        SCHED["Scheduler<br/>K8s: kube-scheduler<br/>Shepherd: filter + score"]
        RC["Replication Controller<br/>K8s: ReplicaSet controller<br/>Shepherd: reconcile loop"]
        SC["Service Controller<br/>K8s: endpoints controller<br/>Shepherd: label matching"]
        NC["Node Controller<br/>K8s: node lifecycle controller<br/>Shepherd: heartbeat timeout"]
        AGENT["Node Agent<br/>K8s: kubelet<br/>Shepherd: Agent"]
        CLI["CLI<br/>K8s: kubectl<br/>Shepherd: sheepctl"]
        EVENTS["Events<br/>K8s: events API<br/>Shepherd: events bucket"]
    end
Це 9 компонентів. В Kubernetes їх 30+. Різниця - в тому, що вирізали.
Що вирізали і чому
| Компонент K8s | Що робить | Чому вирізали |
|---|---|---|
| etcd cluster | Distributed consensus | BoltDB достатньо для single-node |
| Admission webhooks | Валідація/мутація при створенні | Можна валідувати в API handler'ах |
| RBAC | Авторизація | Один юзер, немає потреби |
| Service Accounts | Ідентичність для подів | Немає auth системи |
| Secrets/ConfigMaps | Конфігурація і секрети | Поди беруть env напряму |
| HPA | Автомасштабування | Scale вручну через sheepctl |
| CRDs | Custom resources | Фіксований набір ресурсів |
| CNI | Network plugin interface | Один hardcoded bridge |
| CSI | Storage plugin interface | Volumes через bind mounts |
| kube-proxy | Service routing (iptables) | Endpoints як список IP |
| Ingress | HTTP routing | Немає |
| Watch API | Long-poll для змін | Ticker-based polling |
| Leader election | HA controller manager | Single instance |
| PodDisruptionBudget | Controlled eviction | Немає eviction |
| Rolling updates | Zero-downtime deploys | Delete + recreate |
Що дізнались: мінімальний оркестратор
Після побудови Shepherd стало зрозуміло, що для оркестрації контейнерів на кількох нодах потрібно рівно п'ять речей:
1. API Server - єдина точка входу. Всі компоненти спілкуються через нього. Без центрального API кожен компонент мав би знати про всіх інших.
2. Persistent Store - стан кластера повинен пережити перезапуск. Навіть embedded DB достатньо.
3. Scheduler - алгоритм вибору ноди. Без нього потрібно вказувати ноду вручну для кожного поду.
4. Controllers - reconciliation loops. Без них "хочу 3 репліки" не працює - потрібно вручну створювати кожен під.
5. Agent - хтось на ноді повинен перетворити "под призначений сюди" в реально працюючі контейнери.
Все інше - розширення для production: - Admission = валідація на вході - RBAC = хто може що робити - CRD = extensibility - CNI/CSI = pluggable інфраструктура - Watch = реактивність замість polling
Порівняння в цифрах
| Метрика | Kubernetes | Shepherd |
|---|---|---|
| Рядків коду | ~2,000,000 | ~2,400 |
| Go modules | ~400 | ~2 (bolt, unix) |
| Resource types | 60+ | 5 (Pod, Service, Deployment, Node, Event) |
| API endpoints | 200+ | ~15 |
| Controllers | 30+ | 3 |
| Мін. RAM | 2GB+ | ~20MB |
Чесно про обмеження
Shepherd не підходить для production:
- Single point of failure - один API Server, один BoltDB файл. Впав server - кластер мертвий.
- Немає TLS - весь трафік plain HTTP. Agent до API, sheepctl до API.
- Немає auth - будь-хто може створити/видалити поди.
- Немає rolling updates - scale down + scale up, з даунтаймом.
- Немає pod networking - контейнери в поді не ділять network namespace.
- Немає DNS - тільки IP-адреси, немає service discovery за іменем.
- Немає health checks - liveness/readiness probes відсутні.
Але Shepherd показує, що ці 2400 рядків - це скелет, на якому побудовані 2 мільйони рядків Kubernetes. Всі ті ж патерни: reconciliation, label selectors, async scheduling, desired state.
K3s - реальний мінімальний Kubernetes
Якщо потрібен production-ready мінімальний оркестратор - подивись на K3s від Rancher. Вони зробили те саме: замінили etcd на SQLite, вбудували containerd, прибрали cloud provider integrations. Один бінарник, ~100MB, повна Kubernetes API compatibility.
Різниця: K3s - production ready. Shepherd - навчальний.
Чесно про мінуси
Без TLS і auth будь-хто з доступом до мережі може створювати і видаляти поди. Це прийнятно для localhost, але для multi-node через мережу - security hole. Додати TLS і auth - це ще ~500 рядків коду і управління сертифікатами.
Ще два моменти, які легко недооцінити:
- Ticker polling замість Watch масштабується погано. Кожен контролер раз на інтервал читає весь стан. На десятках ресурсів - норм, на тисячах - CPU горить на повторному читанні незмінних об'єктів.
- BoltDB - один writer. Усі записи серіалізуються через одну транзакцію. Для single-node ок, але це фундаментальна стеля: горизонтально не масштабується, на відміну від Raft-кластера etcd.
💡 Цікаві факти
- Kubernetes виріс з Borg - внутрішнього оркестратора Google. Слово "kubernetes" грецькою означає "керманич, рульовий"; звідси і скорочення "k8s" (8 літер між "k" і "s") та логотип-штурвал.
- etcd named так не випадково: це "/etc" + "distributed" - тобто розподілений конфіг для кластера. Він використовує Raft для консенсусу, і саме тому Kubernetes за замовчуванням рекомендує непарну кількість нод (3, 5, 7) - для кворуму.
- kube-scheduler насправді працює у дві фази, як і Shepherd: спершу filter (відсіює непридатні ноди), потім score (оцінює решту). Той самий патерн, який ми реалізували в кількадесят рядків.
- K3s від Rancher прибрав з бінарника близько мільйона рядків cloud-provider та legacy-коду, обгорнувши результат так, щоб він проходив повний conformance-тест Kubernetes. "Мінімальний" не означає "несправжній".
Що я зрозумів, поки розбирався з темою
Найбільший інсайт - скільки в Kubernetes коду йде не на оркестрацію, а на розширюваність. CRD, admission webhooks, CNI, CSI - це все механізми, щоб дати іншим людям підключатися, не чіпаючи ядро. Сама ж оркестрація - reconcile loop + scheduler + store - дивовижно маленька.
Я думав, що найскладніше буде в плануванні чи мережі. А виявилось, що скелет тримається на одній ідеї: desired state vs actual state, і цикл, що їх зводить. Усе інше - обв'язка навколо цієї однієї петлі.
Що можна покращити
- Замінити ticker-polling на простий long-poll Watch endpoint - це навіть на net/http реалізується і прибирає основну неефективність контролерів.
- Додати health checks (liveness/readiness): без них Pod вважається живим, поки процес не помер, хоча додаток усередині може давно віддавати 500.
- Винести scheduler-плагіни в інтерфейс (filter/score як окремі функції) - це гарна вправа, щоб відчути, як влаштований реальний scheduler framework.
- Додати rolling update в ReplicationController замість delete+recreate: scale up нову версію, дочекатись Ready, scale down стару.
Спробуй сам
# Shepherd - один бінарник:
ls -lh ./shepherd        # ~10MB
# Весь стан - один файл:
ls -lh /var/lib/shepherd/shepherd.db
# Порівняй з K8s:
# etcd cluster + kube-apiserver + kube-scheduler + ...
Далі - де фізично живуть контейнери, образи і стан кластера на диску.
Ресурси
- Kubernetes Components: повна архітектура
- Kubernetes architecture: детальніше
- Borg, Omega and Kubernetes: історичний контекст
Вихідний код циклу: github.com/igorgorovoy/sheep-shepherd-meadow
Попередня: Docker vs Sheep | Наступна: Filesystem Layout