Docker vs Sheep: що насправді робить контейнерний рантайм
Written by:
Igor Gorovyy
DevOps Engineer Lead & Senior Solutions Architect
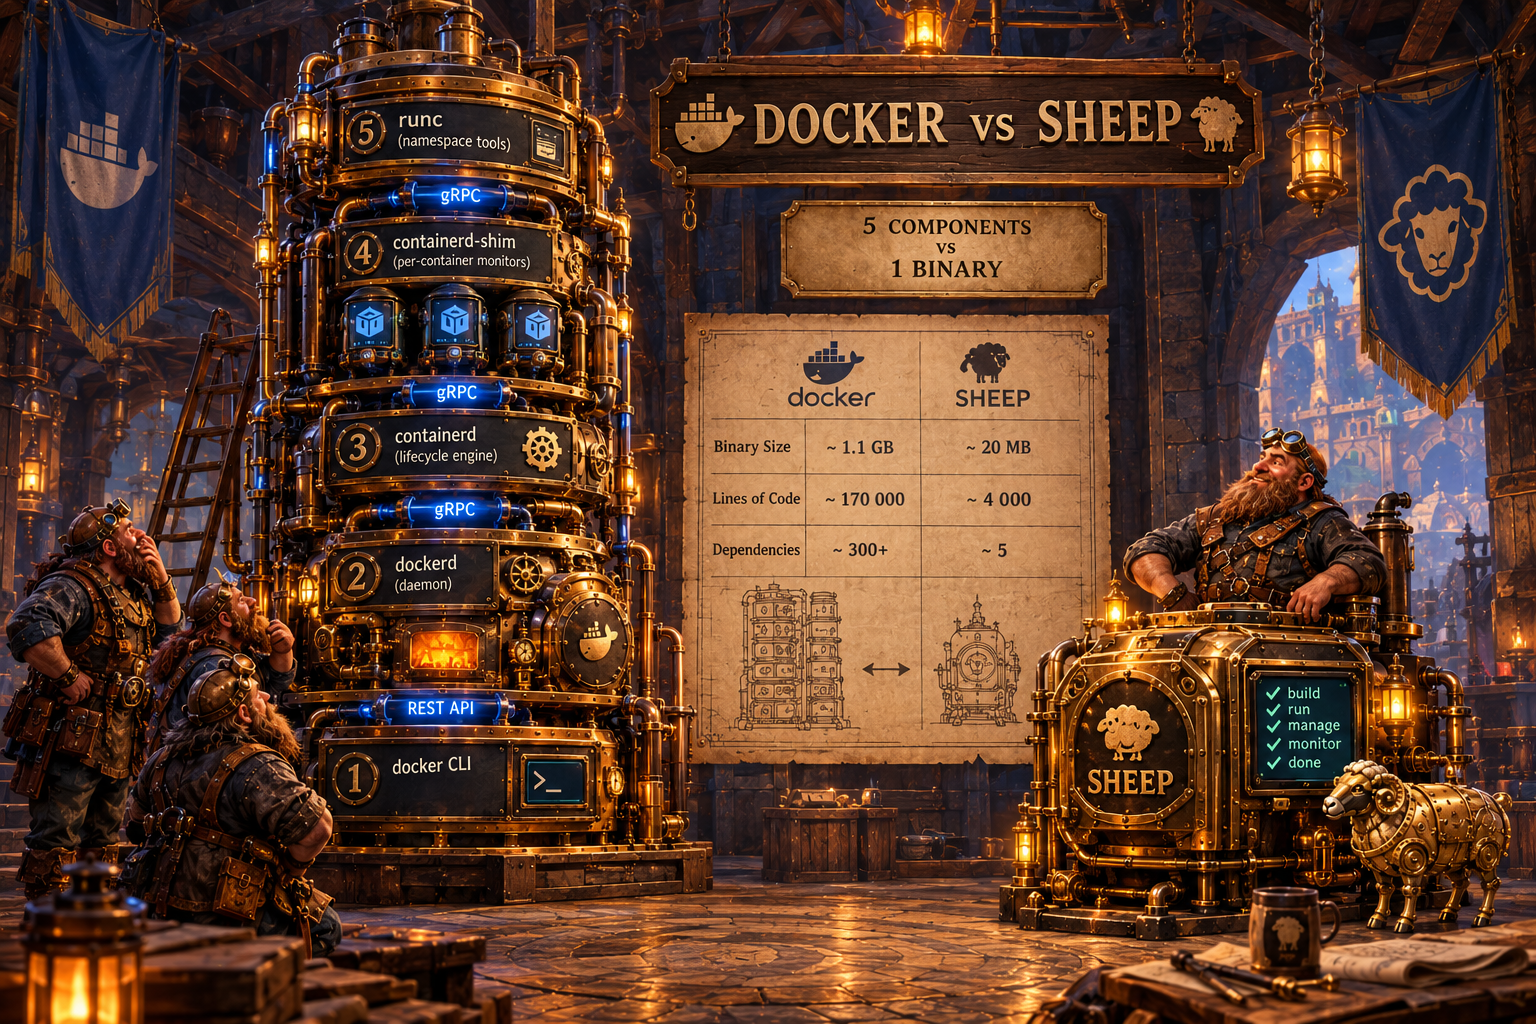
Docker - це стек з п'яти компонентів: docker CLI, dockerd, containerd, containerd-shim, runc. Sheep - один бінарник. Ось що робить кожен компонент Docker і що з цього ми залишили.
Стек Docker
graph TB
    CLI["docker CLI<br/>Парсить команди, REST API клієнт"]
    CLI -->|"REST API<br/>через unix socket"| DOCKERD["dockerd<br/>Docker daemon<br/>Image management, volumes,<br/>networking, build"]
    DOCKERD -->|"gRPC"| CONTAINERD["containerd<br/>Container lifecycle,<br/>image pulling, snapshots"]
    CONTAINERD --> SHIM1["containerd-shim<br/>Process monitor<br/>per container"]
    CONTAINERD --> SHIM2["containerd-shim<br/>..."]
    SHIM1 --> RUNC1["runc<br/>OCI runtime<br/>namespaces + cgroups"]
    SHIM2 --> RUNC2["runc"]
    RUNC1 --> C1["Container 1"]
    RUNC2 --> C2["Container 2"]
Чому так складно? Кожен шар вирішує конкретну проблему:
dockerd - API для зовнішнього світу. Image builds, volumes, networks, compose. Якщо dockerd перезапуститься - containerd продовжує працювати.
containerd - lifecycle контейнерів. Pull images, create snapshots, manage containers. Використовується не тільки Docker, а й Kubernetes напряму.
containerd-shim - один процес на контейнер. Тримає stdin/stdout, відстежує exit code. Якщо containerd перезапуститься - shim продовжує працювати, контейнери не зупиняються.
runc - тільки створення контейнера. Прочитав config.json, створив namespace'и і cgroups, запустив процес, вийшов. Не daemon, а one-shot tool.
Стек Sheep
graph TB
    CLI["sheep CLI<br/>Парсить команди, напряму<br/>викликає Manager"]
    CLI --> MGR["Container Manager<br/>Create, Start, Stop, Remove<br/>State persistence"]
    MGR --> RT["Runtime<br/>startContainer(): namespaces + cgroups<br/>ContainerInit(): mount, pivot_root, exec"]
    MGR --> IMG["Image Manager<br/>Import, Bootstrap, Pull, Push"]
    MGR --> NET["Network<br/>Bridge, veth pairs, IP allocation"]
    MGR --> OVL["OverlayFS<br/>mount/unmount/cleanup"]
    RT --> C["Container process"]
Один бінарник. CLI напряму викликає Manager. Manager напряму створює namespace'и. Немає daemon, немає gRPC, немає shim.
Компонент за компонентом
| Функція | Docker | Sheep | Що втратили |
|---|---|---|---|
| CLI → runtime | REST API через socket | Прямий виклик Go функцій | Можливість віддаленого управління |
| Container monitor | containerd-shim (per container) | go cmd.Wait() в горутині |
Переживання перезапуску daemon |
| OCI runtime | runc (окремий бінарник) | Вбудований в sheep | Взаємозамінність рантаймів |
| Image layers | Content-addressable store, шари діляться | Один rootfs на образ | Дедуплікація шарів |
| Storage driver | overlayfs, btrfs, zfs, devicemapper | overlayfs + copy fallback | Вибір бекенду |
| Networking | libnetwork, CNM, плагіни | bridge + veth, hardcoded | Port mapping, кілька мереж |
| Image build | Dockerfile, BuildKit | Немає | docker build |
Що залишилось - ядро
І Docker, і Sheep роблять одне і те саме на рівні ядра Linux:
1. clone() з прапорцями CLONE_NEW* → namespace'и
2. pivot_root() → ізольована файлова система
3. mount proc, sys, dev → мінімальне оточення
4. cgroups v2 → ліміти ресурсів
5. bridge + veth → мережа
6. iptables MASQUERADE → NAT
Це і є контейнер. Все інше - UX, reliability, ecosystem.
containerd-shim - чого нам не вистачає
Ось конкретний сценарій. Ти запустив 10 контейнерів через Sheep. Потім Sheep впав (баг, kill, оновлення). Контейнери-сироти продовжують працювати (вони ж окремі процеси), але Sheep при наступному старті не знає їхні stdin/stdout, не може отримати exit code.
Docker вирішує це через shim: окремий процес на кожен контейнер, який переживає перезапуск containerd. Shim тримає файлові дескриптори і чекає на exit.
Sheep при перезапуску перевіряє PID:
if c.State == StateRunning && c.Pid > 0 {
    if !isProcessAlive(c.Pid) {
        c.State = StateStopped
        c.Pid = 0
    }
}
Якщо процес живий - вважаємо running. Якщо ні - stopped. Простіше, але exit code втрачається.
Числа
| Метрика | Docker | Sheep |
|---|---|---|
| Binary size | ~50MB (dockerd + containerd + runc) | ~8MB |
| Рядків коду | 100,000+ | ~2,500 |
| Dependencies | ~200 Go modules | ~5 |
| Час старту | ~2с (daemon) | ~10ms |
Sheep на два порядки менший, але Docker обробляє тисячі edge cases, які Sheep просто ігнорує.
Висновок
Docker побудований як layered architecture, де кожен шар можна замінити або перезапустити незалежно. Sheep - монолітний бінарник, де все з'єднано напряму. Для навчання монолітний підхід кращий: ти бачиш весь шлях від CLI команди до Linux syscall в одному call stack.
Де це ламається
Монолітний підхід Sheep означає, що будь-який баг в менеджері може вбити весь рантайм. В Docker layered architecture ізолює збої: containerd може впасти, а контейнери продовжують працювати через shim.
Ще два місця, де монолітність кусає:
- Оновлення Sheep = зупинка всіх контейнерів. У Docker можна оновити dockerd, не торкаючись containerd і запущених контейнерів (live restore). У нас немає поділу на data plane і control plane.
- Один rootfs на образ означає відсутність дедуплікації: десять контейнерів з одного nginx займуть десять копій файлової системи. Docker завдяки content-addressable шарам ділить їх між усіма.
💡 Цікаві факти
- Поділ Docker на dockerd і containerd стався не випадково - containerd навмисно винесли як окремий проєкт і передали в CNCF, щоб Kubernetes міг використовувати його напряму, без Docker. Саме тому K8s зрештою прибрав підтримку Docker як рантайму ("Dockershim removal").
- runc виріс із коду самого Docker: спочатку це був вбудований libcontainer, який потім виділили в окремий бінарник і зробили еталонною реалізацією OCI Runtime Spec. По суті, runc - це той самий код, що колись жив усередині Docker.
- containerd-shim існує переважно заради однієї проблеми: "reparenting". Коли батьківський процес помирає, його діти переходять до init (PID 1). Shim стає проміжним батьком, щоб ловити exit code контейнера навіть після перезапуску демона.
- "Контейнер" - це не сутність ядра Linux. У ядрі немає об'єкта "container", є лише namespaces, cgroups і процеси. Контейнер існує тільки як домовленість у user space - саме тому Sheep може "робити контейнери" тими ж syscall'ами, що й Docker.
Що я зрозумів, поки розбирався з темою
Поки не написав Sheep, я підсвідомо вважав, що в Docker п'ять компонентів через "ентерпрайз" і легасі. А виявилось, що майже кожен шар - це відповідь на конкретний production-біль, з яким я ще не стикався в іграшці: shim - щоб пережити рестарт демона, containerd - щоб його можна було перевикористати без Docker, content-addressable шари - щоб не зберігати десять копій одного образу. Мій "елегантний" монолітний Sheep елегантний рівно до першого збою посеред роботи. Складність Docker - це не роздуття, це накопичені шрами.
Що можна покращити
- Винести моніторинг контейнерів у окремий shim-процес, щоб Sheep міг перезапускатися без втрати exit code і потоків контейнерів.
- Додати content-addressable сховище шарів: зберігати кожен шар за його sha256 і ділити між образами замість повної копії rootfs.
- Розділити монолітний бінарник хоча б на два: довгоживучий runtime-демон і тонкий CLI, що ходить до нього через сокет - це вже дасть віддалене управління.
- Винести створення контейнера за OCI Runtime Spec (читати
config.json), щоб runtime став взаємозамінним і Sheep міг запускати контейнери через runc - або навпаки.
Спробуй сам
# Порівняй розміри:
ls -lh ./sheep           # ~8MB
which dockerd && ls -lh $(which dockerd)  # ~50MB+
# Кількість процесів:
ps aux | grep -c sheep   # 1 + containers
ps aux | grep -c docker  # dockerd + containerd + shim*N
Далі - Kubernetes vs Shepherd: що можна вирізати з оркестратора і залишити його працюючим.
Ресурси
- Docker Engine overview: production-архітектура
- OCI Runtime Spec: що реалізують runc/Docker
- OCI Image Spec: формат образу, який використовує Docker
Вихідний код циклу: github.com/igorgorovoy/sheep-shepherd-meadow
Попередня: JSON serialization