Goroutines для control loops
Written by:
Igor Gorovyy
DevOps Engineer Lead & Senior Solutions Architect
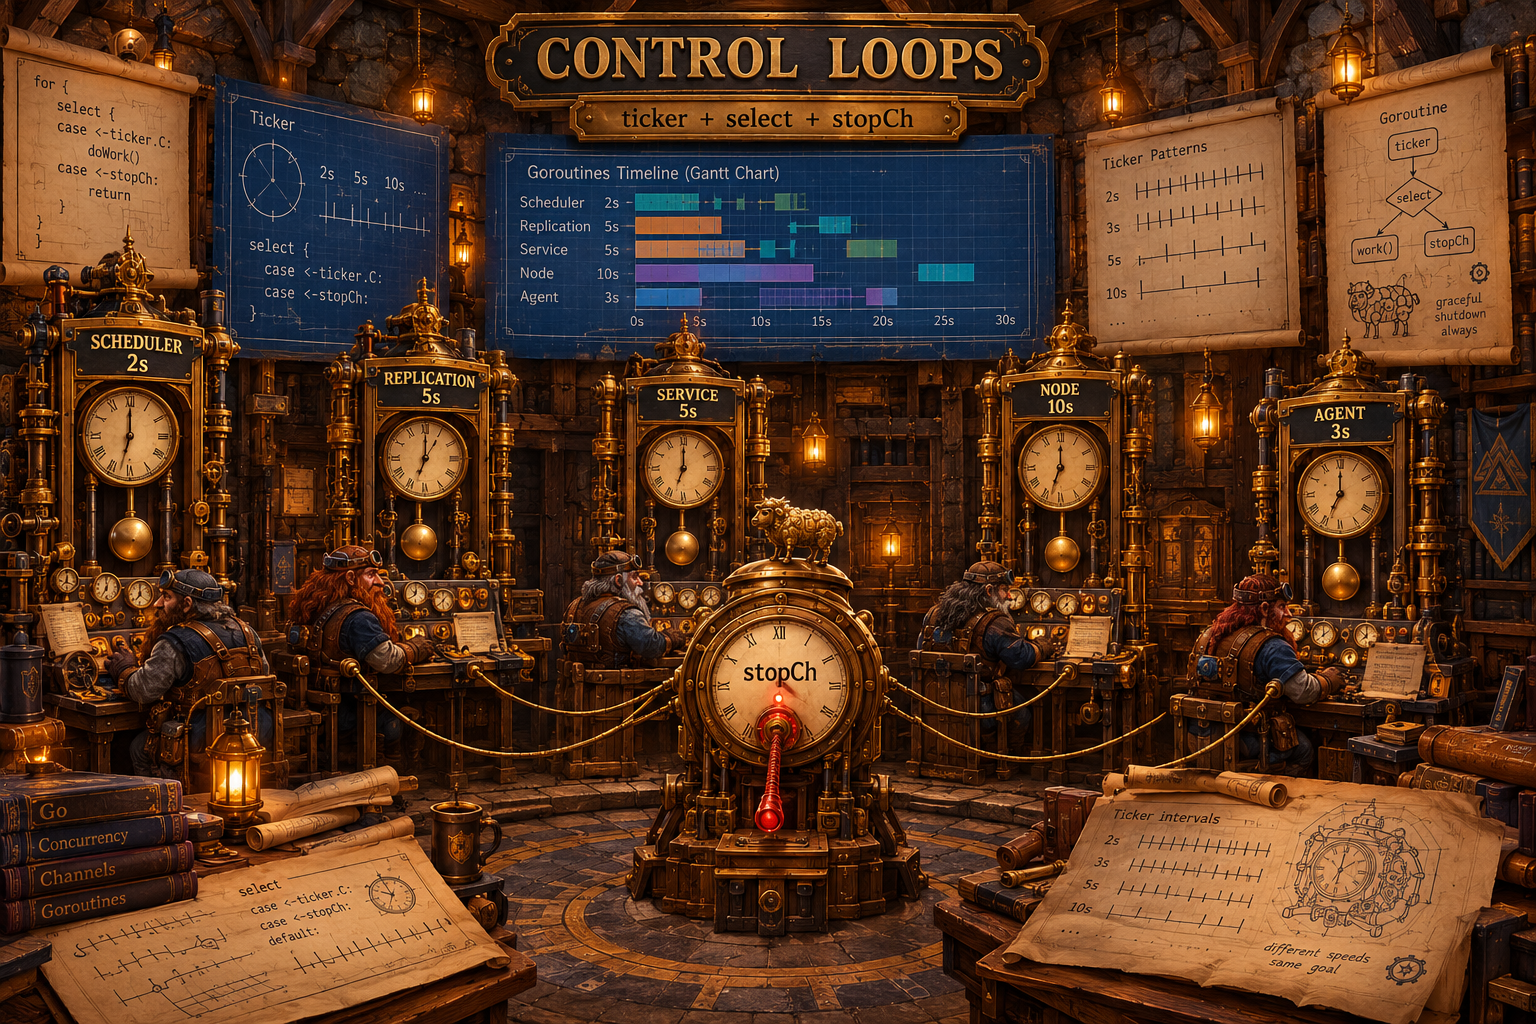
Shepherd запускає 6 паралельних горутин, і кожна живе у своєму ритмі. Scheduler шукає Pending поди кожні 2 секунди. ReplicationController перевіряє кількість реплік кожні 5. Agent шле heartbeat кожні 10 секунд і звіряє поди кожні 3. Між собою вони не спілкуються: спільне в них лише BoltDB Store і один stop channel.
У попередніх частинах я розбирав, що робить кожен контролер, і сам reconciliation loop як ідею. Тут про те, як це все крутиться в Go: тікери, select, спільний стан і що буває, коли щось іде не так. Попередня частина була про syscalls, тобто про низ рантайму; ця про верх, про control plane.
Паттерн: ticker + select + stopCh
Усі контролери зібрані за одним шаблоном:
func (s *Scheduler) Run(stopCh <-chan struct{}) {
    ticker := time.NewTicker(2 * time.Second)
    defer ticker.Stop()

    s.logger.Println("scheduler started")

    for {
        select {
        case <-stopCh:
            s.logger.Println("scheduler stopped")
            return
        case <-ticker.C:
            s.reconcile()
        }
    }
}
select блокується, поки один із каналів не стане готовим. Тікнув тікер - робимо reconcile. Закрився stopCh - виходимо. Дві гілки одночасно не виконуються ніколи.
defer ticker.Stop() тут для порядку. До Go 1.23 без нього тікер жив і після виходу з горутини, і це був класичний витік. З Go 1.23 збирач сміття прибирає тікер, на який ніхто не посилається, навіть без Stop(). Але код, який має збиратися і на старіших версіях, Stop() все одно пише.
Чому саме закриття каналу, а не надсилання значення? close(stopCh) бачать усі, хто з нього читає, скільки б їх не було. Надіслане значення забере тільки один отримувач. Один close() зупиняє чотири контролери разом.
Запуск усіх контролерів
func runServer(addr, dataDir string, logger *log.Logger) {
    store, _ := shepherd.NewStore(dataDir + "/shepherd.db")
    defer store.Close()

    stopCh := make(chan struct{})

    scheduler := shepherd.NewScheduler(store, logger)
    go scheduler.Run(stopCh)

    replicationCtrl := shepherd.NewReplicationController(
        store, scheduler, logger)
    go replicationCtrl.Run(stopCh)

    serviceCtrl := shepherd.NewServiceController(store, logger)
    go serviceCtrl.Run(stopCh)

    nodeCtrl := shepherd.NewNodeController(store, logger)
    go nodeCtrl.Run(stopCh)

    api := shepherd.NewAPIServer(addr, store, scheduler, logger)

    sigCh := make(chan os.Signal, 1)
    signal.Notify(sigCh, syscall.SIGINT, syscall.SIGTERM)

    go func() {
        <-sigCh
        logger.Println("shutting down...")
        close(stopCh)
        api.Shutdown(context.Background())
    }()

    api.Start() // блокується тут
}
graph TB
    MAIN["main goroutine<br/>api.Start() блокується"]

    subgraph "Background goroutines"
        G1["Scheduler<br/>кожні 2с"]
        G2["ReplicationController<br/>кожні 5с"]
        G3["ServiceController<br/>кожні 5с"]
        G4["NodeController<br/>кожні 10с"]
        G5["Signal handler"]
    end

    STOP["stopCh"] -.->|"close()"| G1 & G2 & G3 & G4

    STORE[("BoltDB Store")] <--> G1 & G2 & G3 & G4

    SIG["SIGTERM"] --> G5
    G5 -->|"close(stopCh)"| STOP
    G5 -->|"api.Shutdown()"| MAIN
Усі контролери ділять один store і один stopCh. Кожен читає і пише в Store сам, не питаючи інших. ServiceController збирає endpoints, NodeController дивиться на heartbeat'и. Про те, як сигнал перетворюється на акуратну зупинку, окремо писав у Graceful Shutdown.
Agent: два тікери в одному select
В Agent дві задачі з різними інтервалами. Замість двох горутин тут один select на два канали:
func (a *Agent) Run(stopCh <-chan struct{}) error {
    a.mgr.Init()

    for attempt := 0; attempt < 10; attempt++ {
        if err := a.register(); err == nil {
            break
        }
        time.Sleep(time.Duration(attempt+1) * 500 * time.Millisecond)
    }

    a.logger.Printf("agent %s started, reporting to %s",
        a.nodeName, a.apiAddr)

    heartbeat := time.NewTicker(10 * time.Second)
    defer heartbeat.Stop()

    reconcile := time.NewTicker(3 * time.Second)
    defer reconcile.Stop()

    for {
        select {
        case <-stopCh:
            a.logger.Println("agent stopped")
            return nil
        case <-heartbeat.C:
            a.sendHeartbeat()
        case <-reconcile.C:
            a.reconcilePods()
        }
    }
}
Якщо готові кілька каналів одразу, select вибирає випадково. Тому жоден тікер не "голодує": heartbeat не чекатиме вічно, поки reconcile тікає частіше.
Але дивись, яка штука. Обидві гілки виконуються в одній горутині, по черзі. Якщо reconcilePods() запускає контейнер і це займає 15 секунд, heartbeat ці 15 секунд не піде. NodeController на сервері бачить тишу і може позначити ноду NotReady, хоча вона просто зайнята. Для Shepherd це прийнятно, але якщо reconcile колись стане важким, heartbeat краще винести в окрему горутину.
Конкурентний доступ до Store
Кілька горутин одночасно читають і пишуть у Store. BoltDB дає MVCC: багато читачів паралельно, один writer за раз. Store додає зверху sync.RWMutex для операцій на рівні Go:
type Store struct {
    db *bolt.DB
    mu sync.RWMutex

    podWatchers        []chan Event
    deploymentWatchers []chan Event
    watchMu            sync.Mutex
}

func (s *Store) ListPods(ns string) ([]*Pod, error) {
    s.mu.RLock()         // дозволяє паралельні читання
    defer s.mu.RUnlock()
    // ... s.db.View(...)
}

func (s *Store) CreatePod(pod *Pod) error {
    s.mu.Lock()          // ексклюзивний доступ
    defer s.mu.Unlock()
    // ... s.db.Update(...)
}

func (s *Store) UpdatePod(pod *Pod) error {
    s.mu.Lock()
    defer s.mu.Unlock()

    key := nsKey(pod.Metadata.Namespace, pod.Metadata.Name)
    if err := s.put(bucketPods, key, pod); err != nil {
        return err
    }

    // Сповіщуємо watchers (non-blocking)
    s.notify(s.podWatchers, Event{
        Type:   "Normal",
        Reason: "Updated",
        Object: "pod/" + pod.Metadata.Name,
    })
    return nil
}
Чесно кажучи, RWMutex тут частково дублює BoltDB: у нього і так один writer. Зате м'ютекс захищає і те, що BoltDB не бачить, наприклад списки watchers.
notify надсилає без блокування:
func (s *Store) notify(watchers []chan Event, evt Event) {
    s.watchMu.Lock()
    defer s.watchMu.Unlock()

    for _, ch := range watchers {
        select {
        case ch <- evt:
        default: // канал повний - пропускаємо, не блокуємось
        }
    }
}
default у select означає: якщо канал повний (буфер на 64 події), подію просто пропускаємо. Краще втратити подію, ніж заблокувати writer, який тримає s.mu. Бо поки він стоїть, стоять усі. А втрачену зміну reconciliation loop однаково підхопить на наступному тіку. Той самий принцип "втратити не страшно" є і в Event System.
Timeline одного циклу
gantt
    title Тіки горутин за перші 15 секунд
    dateFormat ss
    axisFormat %S

    section Scheduler (2с)
    tick :s1, 02, 1s
    tick :s2, 04, 1s
    tick :s3, 06, 1s
    tick :s4, 08, 1s
    tick :s5, 10, 1s
    tick :s6, 12, 1s
    tick :s7, 14, 1s

    section ReplicationCtrl (5с)
    tick :r1, 05, 1s
    tick :r2, 10, 1s
    tick :r3, 15, 1s

    section NodeCtrl (10с)
    tick :n1, 10, 1s

    section Agent heartbeat (10с)
    tick :h1, 10, 1s

    section Agent reconcile (3с)
    tick :a1, 03, 1s
    tick :a2, 06, 1s
    tick :a3, 09, 1s
    tick :a4, 12, 1s
    tick :a5, 15, 1s
Перший тік приходить не одразу, а через повний інтервал: time.NewTicker не стріляє в момент створення. Scheduler тікає найчастіше, NodeController найрідше. На 10-й секунді збігаються чотири горутини, і нічого страшного не стається, бо кожна працює сама по собі.
Чому тікери, а не події
Event-driven підхід: змінився под - сповістили scheduler. Швидше, але складніше:
- Подія загубилась. Що тоді?
- Контролер перезапустився і пропустив подію.
- Після падіння треба переобробити все з нуля.
Тікер кожні N секунд перевіряє весь стан. Повільніше, зате:
- Пропущена подія нічого не ламає, підхопимо на наступному тіку.
- Після падіння стан відновлюється сам, це просто черговий тік.
- Немає підписок, replay і черг.
У Kubernetes informers поєднують обидва підходи: watch для швидкої реакції, periodic resync для надійності. Kubelet теж так робить: оновлює свій Lease приблизно кожні 10 секунд, незалежно від того, чи щось змінилося. У Shepherd я залишив тільки тікери. Для десятків ресурсів цього вистачає, а коду менше в рази. Ширше про цю ідею писав у Desired vs Actual State і Async Scheduling.
Обмеження
Якщо reconcile триває довше за інтервал, тікери не накопичуються в чергу. time.Ticker тримає максимум один тік, решту мовчки викидає. Добре те, що після довгого reconcile не прилетить пачка з десяти тіків підряд. Погано те, що горутина, у якої reconcile завжди повільний, ніколи не відпочиває: закінчила, а новий тік уже чекає. Для Shepherd з десятками ресурсів це не проблема. Для тисяч уже знадобиться rate limiting або черга з дедуплікацією, як workqueue в client-go.
Ще кілька речей, які кусаються на практиці:
- Горутина, що спить у
time.Sleepпід час retryregister()в Agent, не реагує наstopCh. Закриєш канал, а вона все одно доспить свій інтервал. Останній retry - це 5 секунд, а за всі десять спроб набігає 27,5 секунд. Для graceful shutdown це відчутна затримка. Лікується черезselectзtime.AfterіstopChзамістьSleep. recoverловить паніку тільки в тій самій горутині, де вона сталася. Якщоreconcile()панікує, падає весь процес: у Shepherd немає supervisor'а, який перезапустив би окремий контролер. З одного боку, це чесно: краще впасти і перезапуститися через systemd, ніж працювати напівживим. З іншого, одна помилка в ServiceController кладе і Scheduler.store, _ := shepherd.NewStore(...)ігнорує помилку. Якщо файл БД зайнятий іншим процесом (BoltDB бере на нього flock), усі контролери отримають nil і впадуть на першому ж тіку.
Цікаві факти
- Control loop вигадали задовго до Kubernetes. Відцентровий регулятор Джеймса Ватта (1788) тримав оберти парової машини: міряв швидкість, порівнював і прикривав клапан. У 1868 Максвелл написав про такі регулятори статтю "On Governors", і з неї рахують початок теорії керування.
- Слово "Kubernetes" з грецької - "керманич", а від того ж кореня (kybernetes) Норберт Вінер у 1948 утворив "кібернетику", науку про керування і зворотний зв'язок. Тож назва Kubernetes буквально описує те, що робить кожен його контролер.
- Горутина стартує з 2 KB стеку, і так з Go 1.4. У Go 1.2 було 8 KB, у 1.0 - 4 KB, а стек складався з сегментів. Сегменти дали проблему "hot split": якщо функція в циклі викликалася якраз на межі сегмента, рантайм постійно виділяв і звільняв новий шматок. У 1.3 перейшли на суцільний стек, який копіюється при рості.
- Випадковий вибір у
selectпрописаний у специфікації мови ("uniform pseudo-random selection"). Це не деталь реалізації. Go рандомізує спеціально, щоб ніхто не покладався на порядок гілок. - Go 1.23 змінив канали таймерів: раніше в
ticker.Cбув буфер на 1, тепер канал синхронний. ПісляStop()абоReset()з нього вже не прочитаєш застарілий тік. Старий код переважно працює як раніше, алеlen(ticker.C)іcap(ticker.C)тепер завжди дають 0. - У kube-controller-manager понад 30 контролерів в одному процесі, і кожен працює так само: власна горутина, власний цикл, спільний стан через API. Shepherd робить те саме, лише з чотирма.
Що я зрозумів, поки розбирався з темою
Спочатку я хотів зробити "по-дорослому": event-driven, watch'і, підписки. А потім помітив, що половина коду - це обробка випадків "а що як подія загубилась". У тікера цієї проблеми нема: наступний тік однаково прийде. "Тупий" periodic reconcile надійніший саме тому, що він stateless, йому байдуже, що сталося між тіками. Тут кращим рішенням виявилося не додати механізм, а прибрати.
Що можна покращити
- Замість фіксованого інтервалу зробити exponential backoff, коли роботи нема, і прискорення, коли є Pending поди. Зараз scheduler тікає вхолосту навіть на порожньому кластері.
- Додати
sync.WaitGroup, щобmainдочекалася реального завершення горутин післяclose(stopCh), а не просто закрила канал і пішла. - Перейти зі
stopChнаcontext.Context. Тоді дедлайни і скасування дійдуть до самих reconcile-функцій, а не лише до циклу select. - Винести інтервали в конфіг. Зараз 2с/5с/10с зашиті в код, і щоб їх змінити, треба перекомпілювати.
- Обгорнути кожен
reconcile()уdefer recover()з логуванням, щоб паніка в одному контролері не клала весь процес.
Спробуй сам
# Запусти shepherd і подивись логи контролерів:
shepherd --mode standalone 2>&1 | grep -E 'started|reconcil'
# Побачиш, як тікають усі контролери
Про те, чим standalone відрізняється від окремих server і agent, є в Two-Mode Architecture.
Далі - CLI без фреймворків: subcommand routing на чистому os.Args.
Ресурси
- Effective Go: Concurrency: офіційний посібник з конкурентності в Go
- Go Concurrency Patterns: класична доповідь Роба Пайка
- Go 1.23 release notes: Timer changes: що змінилося в
time.Timerіtime.Ticker - The Go Programming Language Specification: Select statements: звідки береться випадковий вибір
- Patterns of Distributed Systems: патерни control plane
Вихідний код циклу: github.com/igorgorovoy/sheep-shepherd-meadow
Попередня: Go Syscalls | Наступна: CLI без фреймворків